
GPU 与内存芯片差在哪:英伟达只设计,美光连晶圆厂都自己建
发布日期:2026-10-10
同样是芯片,两家公司的活法完全相反:英伟达只画电路图,晶圆制造与先进封装全部交给台积电,公司名下没有一座自己的晶圆厂;美光则把设计、流片、封装测试全部攥在手里,2026 财年资本开支超过 250 亿美元,2027 财年仅厂房建设一项就计划再增投超 100 亿美元。这一轻一重的分岔不是经营偏好,而是由芯片类型决定的——GPU 是逻辑芯片,DRAM 和 NAND 是存储芯片,两者的单元结构、设计方法、工艺路线各走各的路。本文从单元结构讲起,拆解两类芯片在设计、制造、工艺上的异同,最后落到先进封装这个把两条路重新绑在一起的交汇点上。
先给一个总览:芯片行业其实分成两大类。一类是逻辑芯片,GPU、CPU、手机 SoC 都属于这一类,它的本质是把几十亿个晶体管组织成千变万化的电路;另一类是存储芯片,DRAM、NAND 属于这一类,它的本质是把同一种存储单元复制到极致。前者难在"不一样",后者难在"都一样"。这个根本差异,顺着链条一路决定了谁用 EDA 工具画版图、谁用工艺配方守产线,也决定了英伟达可以一无所有地站在市值顶端,而美光必须把几百亿美元砸进厂房。
| 维度 | 逻辑芯片(GPU / CPU) | 存储芯片(DRAM / NAND) |
|---|---|---|
| 基本单元 | 晶体管组成功能各异的模块 | DRAM 是 1 晶体管 + 1 电容;NAND 是电荷存储管 |
| 结构特征 | 不规则、功能导向 | 高度规则、面积导向,单元重复到极致 |
| 设计方法 | 标准单元库 + 综合 + 布局布线 + 时序签核 | 全定制版图,像模拟电路一样手工优化 |
| 核心指标 | 算力、能效、软件生态 | 密度、速度、每 GB 成本 |
| 微缩方向 | 晶体管继续缩小:FinFET 走向 GAA | 平面微缩逼近极限,转向垂直堆叠 |
| 主要玩家 | 英伟达、AMD、英特尔(设计)+台积电、三星(代工) | 三星、SK海力士、美光、铠侠等少数厂商主导 |
一、先分清两种芯片:一个是逻辑,一个是阵列
GPU 是逻辑芯片的典型代表。一颗现代 GPU 里,有承担通用计算与图形的流式处理器、专门做矩阵乘法的张量核心、多级缓存、显存控制器、还有负责多卡互联的网络单元——每个模块功能不同、形状不同、时序要求也不同。设计一颗 GPU,本质上是把几十种不同的电路模块,在指甲盖大小的硅片上摆对位置、连对信号、收住时序。
存储芯片走的是另一条路。DRAM 的最小单元是"一个晶体管加一个电容",业内叫 1T1C:晶体管当开关,电容存电荷,有电是 1、没电是 0。整个存储阵列,就是这一个单元复制几十亿次。NAND 更极端,把电荷存进一个悬浮的栅极里,再把成串的单元垂直堆起来。存储芯片的版图上,绝大部分面积都是一模一样的重复结构,外围只有一小圈负责读出放大、行列译码和刷新控制的电路。
这个差别看起来只是"画法不同",实际决定了一切。逻辑芯片的晶体管虽然数量惊人,但种类多、重复度低,设计的主战场是功能正确与时序收敛;存储芯片的单元虽然简单,但重复度极高、对一致性极其敏感,几十亿个电容必须表现出几乎相同的漏电和保持时间,任何一个工艺偏差都会被复制几十亿次。所以逻辑芯片的竞争力写在电路设计里,存储芯片的竞争力写在工艺配方里——这句话是后面所有差异的起点。
二、设计:一个靠 EDA 流水线,一个靠手工版图
逻辑芯片的设计是一条流水线。架构团队先用硬件描述语言写出电路,再由综合工具自动把它翻译成标准单元的组合,布局布线工具负责摆放和连线,时序签核工具检查信号能不能在规定时间内到达。这条流水线还能大量复用外来 IP:CPU 核可以买 ARM 的,高速接口可以买现成的 SerDes,连 HBM 的物理层接口都有第三方方案。设计公司真正的独门东西,是架构决策和软件生态,而不是每一个晶体管。
存储芯片的设计更接近模拟电路。存储单元没有现成的库可以买,版图要工程师手工画、手工调,电容的形状、介质层的厚度、字线位线的排布,每一处都要反复仿真。DRAM 的设计难点甚至不在"存",而在"读":电容里的电荷微弱到需要灵敏放大器去分辨,这个电路的设计窗口只有纳秒级。所以存储厂商的芯片设计部门,和自家工艺研发部门是绑在一起工作的——业内有个专门的说法叫设计工艺协同优化,意思是电路和工艺必须一起改,谁也离不开谁。
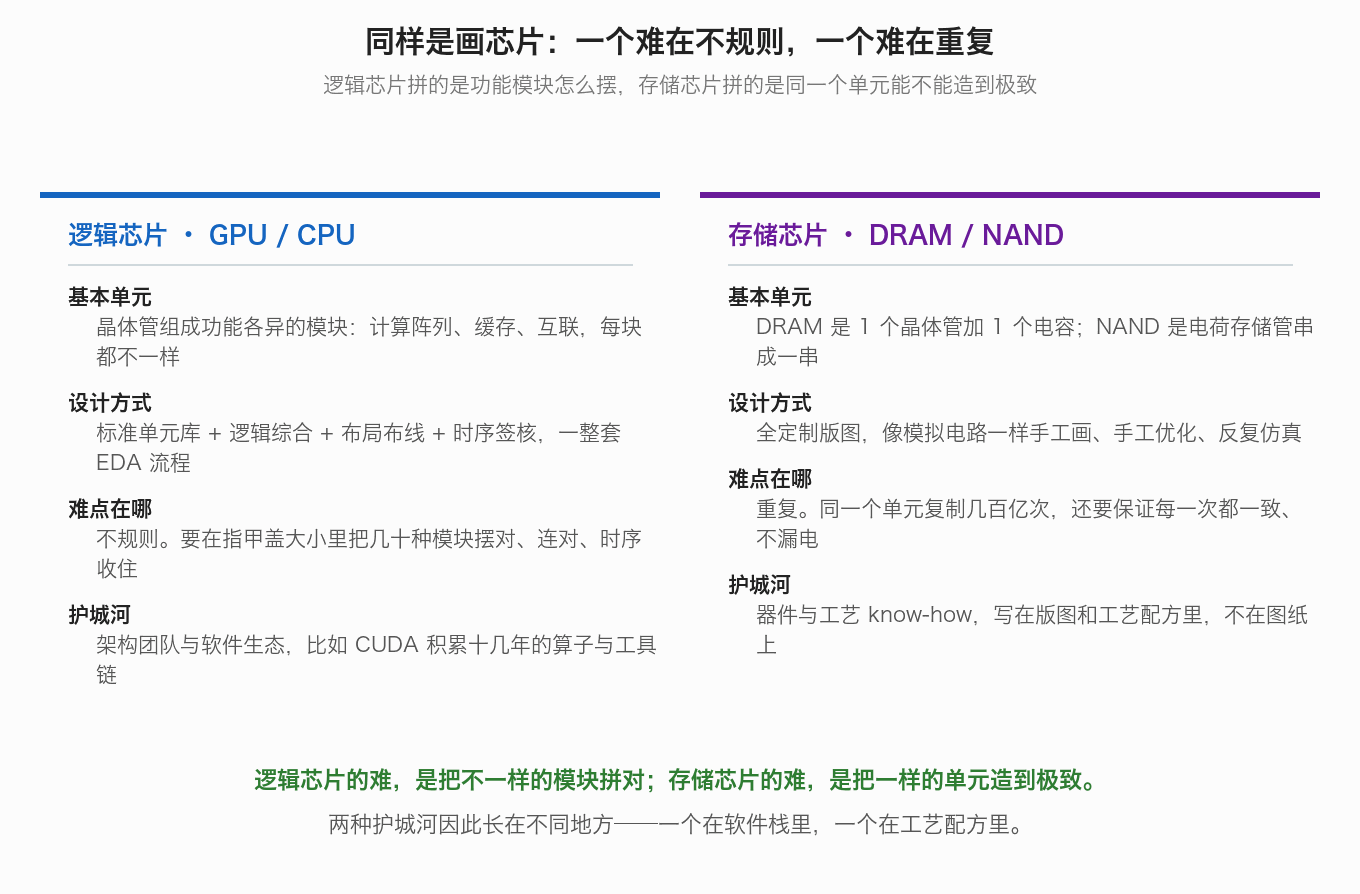
这也解释了一个容易误解的现象:为什么英伟达的设计团队可以换工艺、换代工厂,而美光的设计团队离不开自家产线。因为逻辑芯片的设计成果是一套可以移植的电路描述,换一家代工厂重新做一遍物理实现就能跑;存储芯片的设计成果是电路与工艺的耦合体,电容的每个参数都对应着特定产线的特定配方,把它交给别人的工厂,等于把命脉和 know-how 一起交出去。
| 环节 | 逻辑芯片(GPU) | 存储芯片(DRAM / NAND) |
|---|---|---|
| 设计起点 | 架构规格与硬件描述代码 | 电路规格与器件参数 |
| 主力工具 | 逻辑综合、布局布线、时序签核 | 全定制版图编辑与电路仿真 |
| 单元来源 | 标准单元库,IP 可外购 | 存储单元自研,无库可买 |
| 验证重点 | 功能正确与时序收敛 | 单元一致性与良率 |
| 与工艺的关系 | 设计可移植,换厂重新实现即可 | 设计与工艺耦合,必须协同开发 |
三、制造:为什么英伟达不建厂,美光不能不建
芯片制造业的分工方式,大致有四种。第一种是无厂设计,只做设计,把制造外包,英伟达、AMD、高通、博通都是这一类;第二种是纯代工,不卖自己的芯片,只把别人的设计做成硅,台积电、格芯、联电属于这一类;第三种是垂直整合,设计、制造、封装测试一条龙,美光、三星、SK海力士、英特尔是典型;第四种正在出现——系统厂商自建一条龙,比如特斯拉与 SpaceX 规划中的 Terafab 芯片园区,把逻辑、内存与先进封装放进同一个园区。
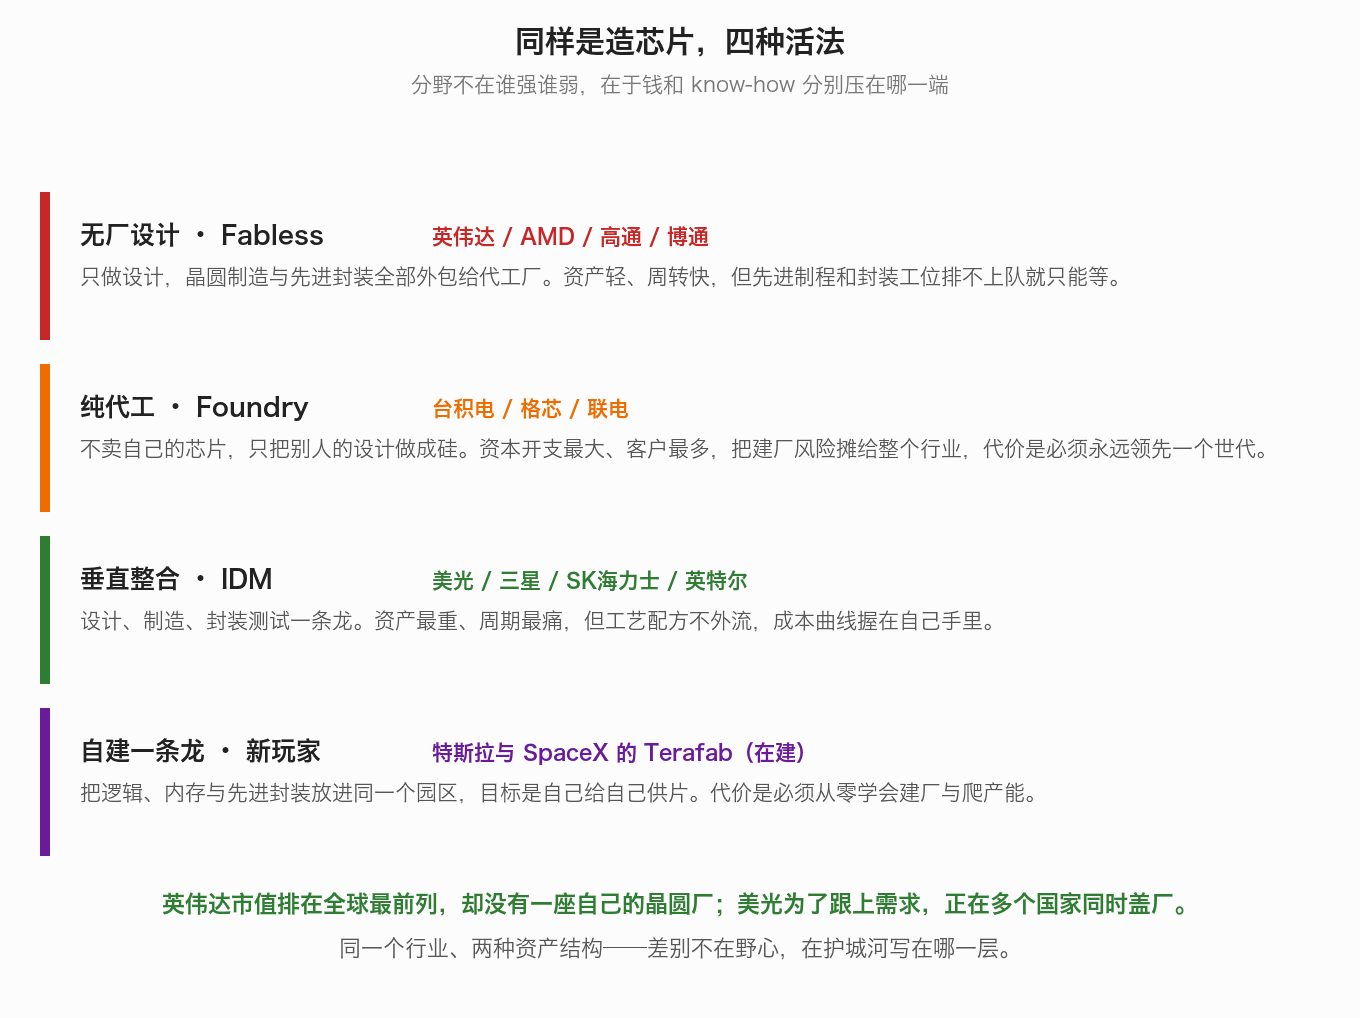
英伟达是无厂模式的极致样本。GPU 的逻辑裸片交给台积电,用最先进的制程生产;封装环节用的是台积电的 CoWoS 先进封装——把逻辑裸片和几组高带宽内存并排焊在一块硅中介层上。这门封装生意如今紧俏到什么程度:行业测算 2026 年 CoWoS 需求约 100 万片晶圆,接近 2024 年约 37 万片的 3 倍;有分析估计英伟达一家拿走其中约六成,前三家客户合计占八成以上。台积电管理层在股东会上说产能"极度紧张、2026 年内售罄",在财报会上进一步说封装产能"紧到限制客户的成长"。一个不拥有任何工厂的公司,卡着全球最紧的产能。
美光是另一个极端。它是总部位于美国的大型存储原厂中仅存的一家,DRAM 与 NAND 从设计到量产全部自己做。为了跟上 AI 带来的存储需求,它的扩产清单横跨四大洲:爱达荷州首座晶圆厂预计 2027 年年中产出首批晶圆,第二座预计 2028 年末;纽约基地首座厂已动工;收购来的中国台湾铜锣厂区预计 2028 财年出货,并计划在 2026 年前再建同等规模的第二座洁净室;日本广岛基地扩建洁净室;新加坡同时新建一座 NAND 晶圆厂和一座 HBM 先进封装厂;印度的封测厂已经商业出货。公司口径的 2026 财年资本开支超过 250 亿美元,2027 财年厂房相关支出还要同比再增超 100 亿美元。
两种模式的差别,归结起来是四个问题。
第一,护城河写在哪。英伟达的壁垒是架构和软件生态,这些资产跟着人走、不跟着厂房走,外包制造不会流失核心能力;美光的壁垒是器件与工艺配方,这些知识只存在于自家产线上,外包等于拱手让人。第二,产品是定制还是大宗。GPU 是高毛利、相对小批量的复杂产品,可以承受代工溢价;存储是高度标准化的大宗商品,价格随周期剧烈波动,谁家的每 GB 成本更低,谁才能活过下行周期,而成本优势只能从自家产线的规模和工艺里抠出来。
第三,风险怎么分摊。建一座先进晶圆厂动辄上百亿美元、还要持续投入设备,纯代工厂靠服务上百家客户把这笔风险摊薄,台积电 2026 年的资本开支目标就落在 600 亿到 640 亿美元之间;IDM 只能自己扛,但换来的是产能和配方都不受制于人。第四,竞争格局不同。逻辑芯片设计公司有上百家,谁都能去找台积电排队;存储是三家寡头主导的市场,谁敢停止投资,谁就在下一轮成本战里出局——这也是为什么存储行业的资本开支在缺货和过剩两种状态下都降不下来。
| 维度 | 无厂设计(英伟达) | 垂直整合(美光) |
|---|---|---|
| 资产结构 | 轻资产,研发与人员为主 | 重资产,厂房与设备为主 |
| 资本开支 | 以研发投入为主 | 2026 财年超 250 亿美元,2027 财年继续加码 |
| 定价方式 | 高毛利,生态锁定带来定价权 | 周期定价,随供需剧烈波动 |
| 最大风险 | 产能不在自己手里,排不上队只能等 | 建厂周期以年计,需求反转时产能变包袱 |
| 竞争壁垒 | 架构 + 软件生态 | 工艺配方 + 成本曲线 |
四、工艺路线:一个还在横向缩,一个开始往上堆
两类芯片的工艺路线也在分岔。逻辑芯片还在做熟悉的事:把晶体管做得更小。台积电的 3 纳米并不是物理上 3 纳米宽的晶体管,而是一个世代的代号——在同样功耗下性能比上一代 5 纳米提升约 15% 到 20%,靠的是极紫外光刻把线宽压到十几纳米,而全球能造极紫外光刻机的只有一家公司。下一站是 2 纳米,晶体管结构从鳍式换成环绕栅极,电流控制得更紧、漏电更少。
存储芯片的平面微缩已经逼近极限。DRAM 的工艺节点用希腊字母标记,从 1α、1β 到 1γ,最小间距从约 14 到 15 纳米压到约 10 到 11 纳米,单元面积缩小了将近一半;但电容要维持足够的存储量,高度却越做越高,深宽比越来越极端,漏电和保持时间越来越难伺候。业内普遍的判断是,平面 1T1C 结构再往下缩的收益已经不大,出路是换维度:要么把晶体管的沟道立起来,要么像 3D NAND 那样把整个阵列分层堆叠——后者的量产时间表普遍指向 2030 年前后。
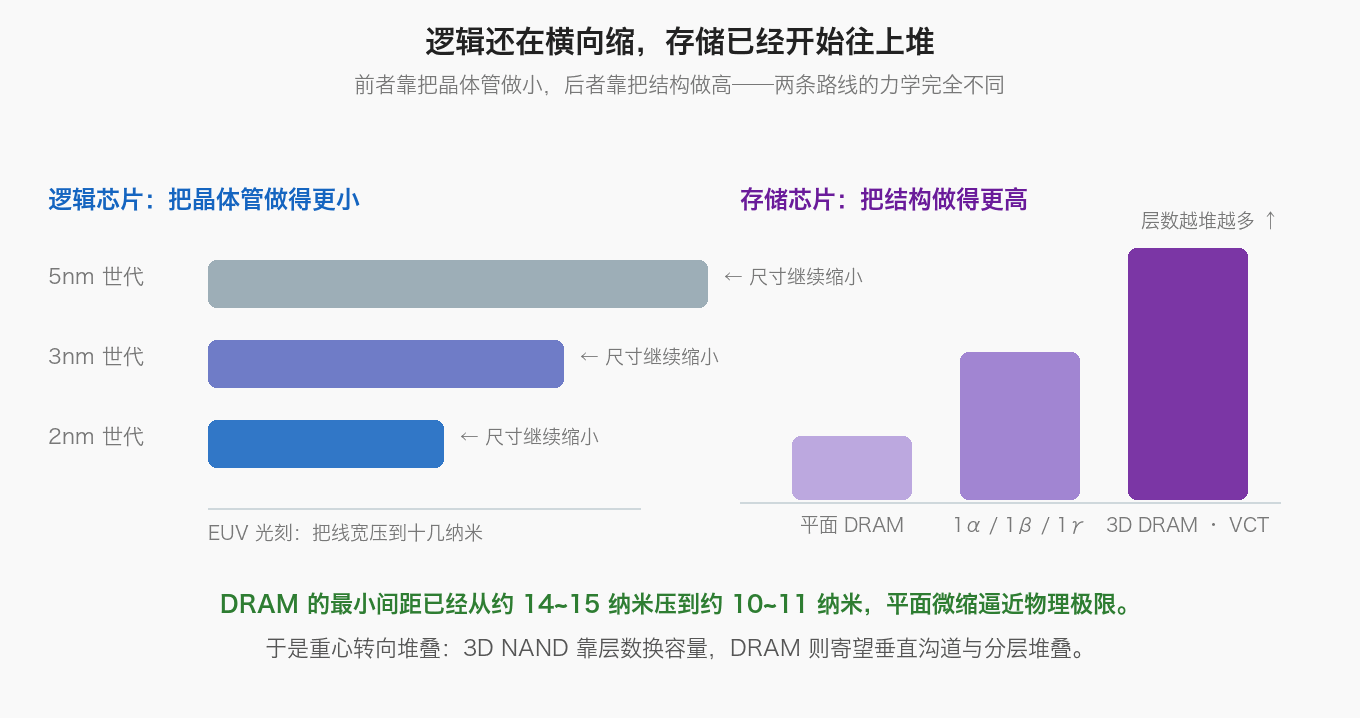
这条分岔直接解释了存储行业为什么必须不停盖厂。逻辑芯片每一代微缩都能在同样面积里塞进更多晶体管,老厂升级就能增产;存储芯片的平面微缩红利枯竭之后,每片晶圆能产出的位数增长在放缓,要更多容量就只能建更多洁净室、铺更多产线。存储原厂自己也承认这一点:先进节点的位元密度增益在下降,洁净室产能有限,还要在 DRAM 和 NAND 之间来回腾挪。对逻辑芯片来说,建厂是扩张手段;对存储芯片来说,建厂是生存必需。
五、交汇点:HBM 把两条路焊在一起
如果说前四节讲的是分岔,这一节要讲的是那个把两条路重新绑在一起的零件。高带宽内存 HBM 的做法是:存储原厂把 DRAM 裸片用硅通孔垂直堆叠成 8 到 16 层,做成一个矮胖的堆栈;然后由逻辑代工厂用先进封装,把这个堆栈和 GPU 的逻辑裸片并排放在同一块硅中介层上,中间用数千条细密布线连起来。一颗 AI 加速器,就这样同时用到了两条完全不同的产业链。
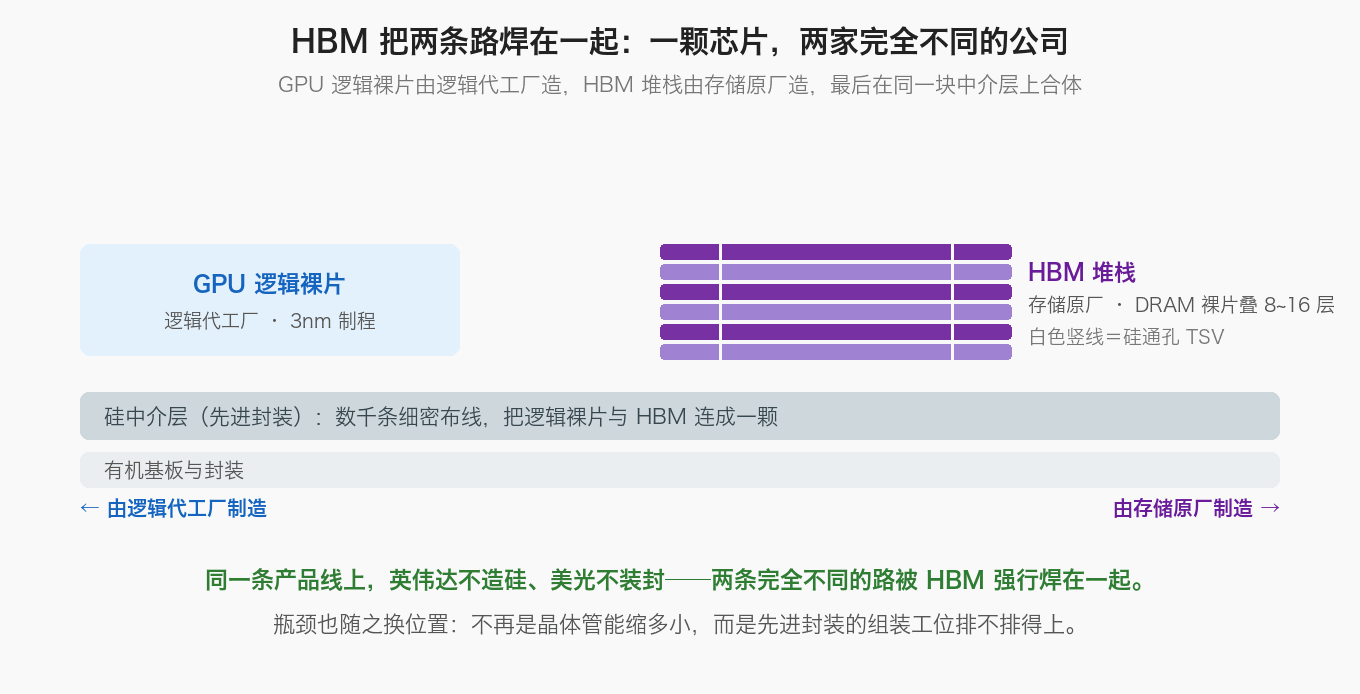
分工细到什么程度,看两件最近的事就够。一件是 2026 年 10 月 8 日,格芯与台积电签下约 20 亿美元、为期五年的协议,在纽约州的工厂为台积电的 CoWoS 封装体系生产硅中介层——这是美国本土第一次出现这类中介层的供应来源,量产爬坡预期在 2028 年上半年。连中介层这种"不需要最先进晶体管"的部件,都开始按专业化原则分配。另一件是马斯克的表态。10 月 7 日,他明确表示得州的 Terafab 芯片园区将由特斯拉与 SpaceX 自己建设、自己运营,台积电最多只能分租部分厂区;英特尔已在 4 月加入项目担任开发伙伴,计划采用英特尔的 14A 制程。这个项目一期投资约 168 亿美元,全部阶段的投资可能高达上千亿美元——一家长期外包芯片制造的系统公司,第一次认真地考虑把晶圆厂搬进自家院子。
但 Terafab 也从侧面印证了自建有多难。台积电董事长的说法是行业基本规律:建一座新厂要两到三年,爬到满产还要一到两年。对英伟达来说,这条学习曲线没有任何必要去爬——设计和生态才是它的护城河,产能可以用钱和长约锁定;对美光来说,这条曲线却必须自己走完,因为存储的成本与配方就是它的全部。所以"要不要自建晶圆厂"从来不是一个技术偏好问题,而是一个定位问题:你的护城河写在电路里,还是写在工艺配方里。
| 环节 | 谁在做 | 现状 |
|---|---|---|
| GPU 逻辑裸片 | 台积电等逻辑代工厂 | 英伟达被认为拿走约六成先进封装产能 |
| HBM 堆栈 | SK海力士 / 三星 / 美光 | 存储原厂自产,硅通孔堆叠 8~16 层 |
| 硅中介层 | 台积电为主,格芯新签约 | 约 20 亿美元五年协议,2028 年上半年爬坡 |
| 整线封装 | 逻辑代工厂与封测厂 | 产能紧到被认为在限制客户成长 |
结语
把这一路看下来,GPU 和内存芯片的异同可以压缩成四句话。相同点有两条:都建立在硅基工艺上,都要经过光刻、刻蚀、薄膜沉积这些环节,都受同样的资本周期和地缘约束。不同点更多:单元结构上一个不规则、一个重复到极致;设计方法上一个走 EDA 流水线、一个做全定制版图;工艺路线上一个继续横向微缩、一个转向纵向堆叠;产业模式上一个可以无厂、一个必须垂直整合。
最有意思的是结局:两条路分岔了几十年,最后被 HBM 和先进封装焊回了同一颗芯片上。于是我们看到了这个行业最真实的一面——没有哪种模式天然更优,只有哪种模式配得上哪条护城河。英伟达不拥有厂房,却卡着全球最紧的封装产能;美光把工厂开遍四大洲,护城河却依然是那一纸工艺配方。下次再听到"某某公司要自建晶圆厂",先别急着判断是雄心还是冒险,问一句就够了:它的核心竞争力,离开自己的产线还能不能活着带走?
口径说明:本文数据截至 2026-10-10。美光的资本开支、扩产项目时间表与产能表述来自公司 2026 财年第二季度财报电话会,为公司口径;台积电的 CoWoS 产能表述来自公司股东会与财报电话会,2026 年约 100 万片晶圆的需求测算、英伟达约六成的份额估计均为行业分析与媒体估算,非台积电官方披露;3 纳米与 5 纳米的性能对比为代工厂公开口径,"3 纳米"为世代代号而非物理尺寸;DRAM 各节点的间距、单元面积与 3D DRAM 时间表来自行业技术分析,不同机构口径存在差异;格芯与台积电的协议金额、期限与爬坡时间为格芯官方新闻稿口径;Terafab 的投资规模、制程选择与运营主体均来自公司表态与媒体报道,项目仍在推进中、细节可能变化。文中对两类芯片设计方法与工艺路线的归纳为技术常识性梳理,具体厂商做法存在差异。
资料来源:美光科技 2026 财年第二季度财报电话会(2026-03)、台积电 2026 年 6 月股东会与第二季度财报电话会、格芯 2026-10-08 官方新闻稿、彭博社与界面新闻关于 Terafab 的报道、AnySilicon 与 Industrial Info 对中介层协议的梳理、BonTech Labs 与 TechNews 关于 DRAM 器件与 3D 堆叠的技术分析、ASML 极紫外光刻公开资料。
本文为公开信息梳理与技术讨论,不构成任何投资建议。